
Elasticsearch’te Gerçek Maliyet Nerede Başlar? Lisansın Ötesinde Mimari, Kapasite ve Storage Tasarımı
Teknolojinin bazı konuları vardır; ilk karşılaştığınızda karmaşık görünür, ancak mantığını kavradıkça yalnızca anlamakla kalmaz, üzerine düşünmekten ve konuşmaktan da büyük keyif almaya başlarsınız. Elasticsearch’ün veri saklama mimarisi benim için tam olarak böyle bir konu. Özellikle büyük ölçekli kurumsal ortamlarda Elasticsearch tabanlı bir çözümü değerlendirirken aklıma gelen ilk soru, ne kadar lisans satın alınması gerektiği değil, nasıl bir mimari tasarlamamız gerektiği oluyor. Çünkü teknoloji yatırımının gerçek maliyeti yalnızca yazılım aboneliğinden oluşmuyor. Sunucularımızın işlemci ve bellek kaynakları, depolama altyapımız, ağ kapasitemiz, yüksek erişilebilirlik gereksinimlerimiz, felaket kurtarma yaklaşımımız ve operasyonel süreçlerimiz de toplam sahip olma maliyetimizi belirliyor. Bu nedenle bir Elastic projesinin başarısının, yazılım kurulmadan çok önce, kâğıt üzerinde başladığını düşünüyorum.
Elastic Stack, en temel hâliyle Elasticsearch, Logstash ve Kibana gibi bileşenlerden oluşan, farklı veri kaynaklarından gelen bilgilerin toplanmasını, işlenmesini, saklanmasını, aranmasını ve analiz edilmesini sağlayan bir teknoloji ekosistemi. Geleneksel olarak Elasticsearch, Logstash ve Kibana bileşenlerinin baş harflerinden oluşan ELK adıyla tanıdığımız bu yapı, günümüzde Elastic Agent, Fleet ve OpenTelemetry tabanlı bileşenlerle çok daha kapsamlı kullanım alanlarına sahip.
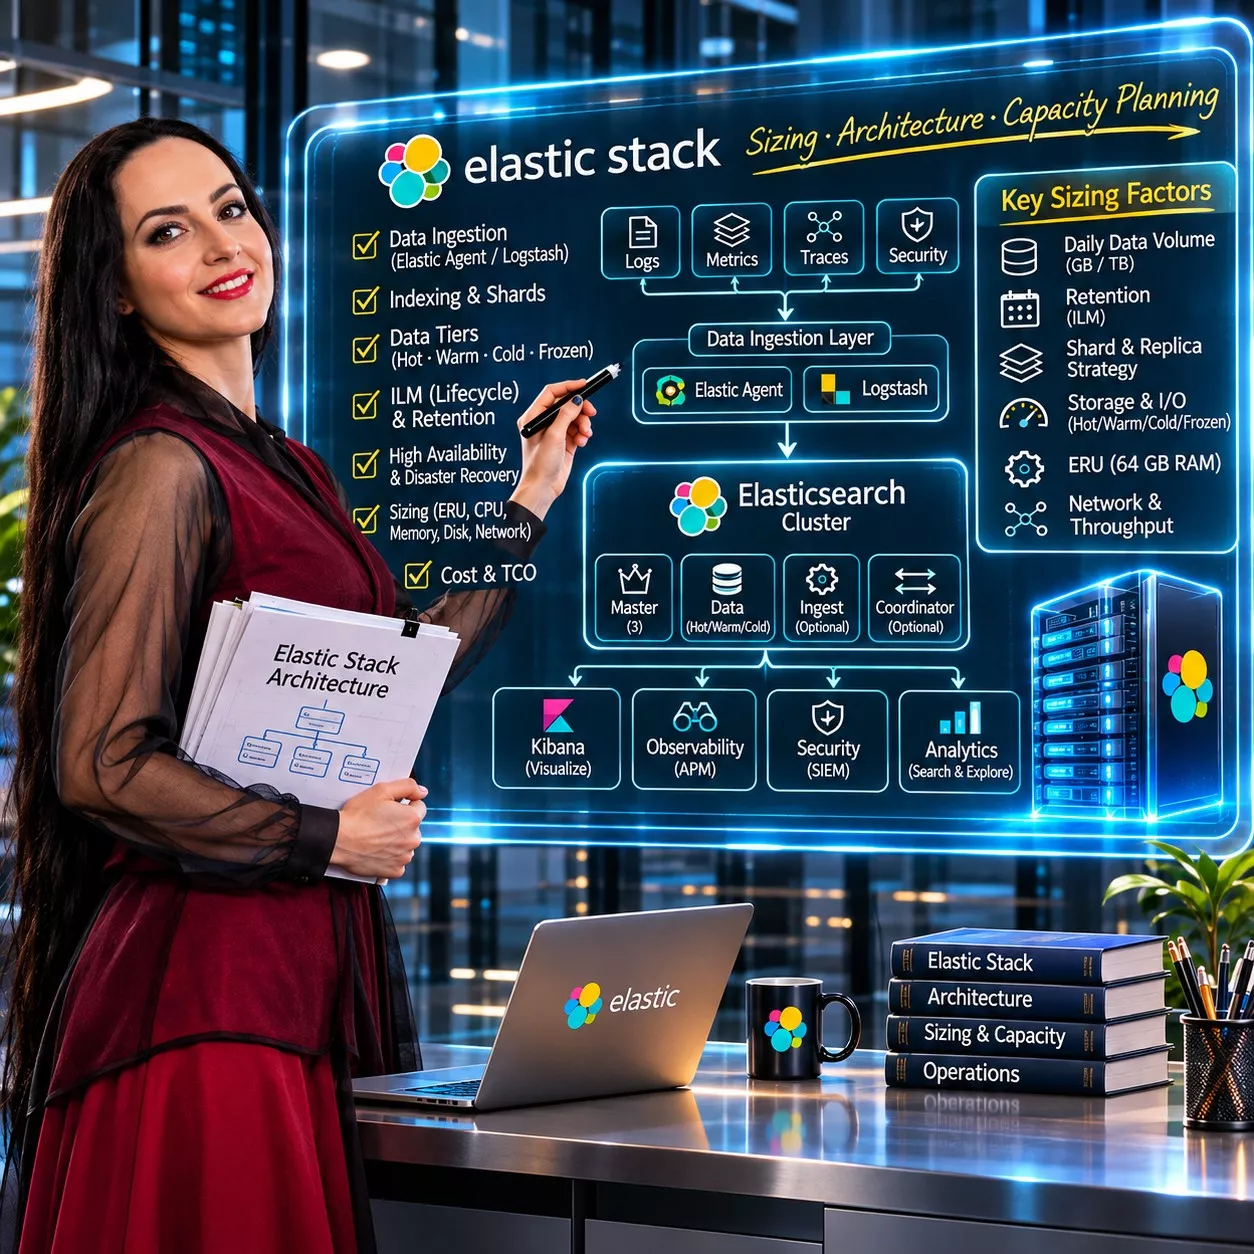
Ancak her projenin aynı bileşenlere ihtiyacı yok. Yalnızca merkezi log yönetimi gerçekleştireceğimiz bir ortamla, uygulamaların performansını uçtan uca izleyeceğimiz bir ortamın mimarisi, ürettiği veri miktarı ve kaynak tüketim davranışı birbirinden oldukça farklı olabilir. İşte bu nedenle ölçeklendirmeyi yalnızca kaç Elastic Enterprise Resource Unit (ERU) gerektiğini hesaplamak ve buna uygun aboneliği satın almak olarak görmüyorum. Lisanslama, kapasite planlamasının önemli bir parçasıdır; ancak tek başına bir çözümün ne kadar işlemci, bellek, disk ve ağ kapasitesine ihtiyaç duyacağını ortaya koymaz. Elastic’in self-managed Enterprise lisanslama modelinde 1 ERU, lisanslamaya tabi 64 GB bellek kapasitesini temsil eder. Örneğin 2 ERU satın almam, ilgili lisans kapsamındaki bileşenler için toplam 128 GB bellek kapasitesi hakkı sağlar. Ancak bu, mimarimi nasıl tasarlamam gerektiğini söylemez. Elasticsearch cluster’ımı 3 node ile mi, 6 node ile mi oluşturmalıyım? Bu node’ların hangileri master, hangileri data rolünde çalışmalı? Her node’a ne kadar işlemci, bellek ve disk ayırmalıyım? Kibana, Logstash ve diğer gerekli bileşenleri nasıl konumlandırmalıyım? Üstelik bütün bu bileşenlerin yüksek erişilebilirliğini ve gerektiğinde coğrafi yedekliliğini nasıl sağlayacağım?
İşte gerçek kapasite planlaması, lisans miktarını belirlemekten çok daha fazlasını gerektiriyor.
Asıl sorumuz şu olmalı: Hangi iş ihtiyacını karşılamak istiyoruz, bu ihtiyacı karşılamak için hangi mimari bileşenlere gereksinimimiz var ve bu bileşenler hangi kaynaklarla, hangi erişilebilirlik seviyesinde çalışmalı?
Bu soruyu cevaplayabilmek için önce girdilerimizi doğru tanımlamamız gerekiyor. Örneğin merkezi log yönetimi kuracağımızı düşünelim. Kaç farklı kaynaktan log toplayacağız? Günlük ortalama ve en yüksek veri hacmimiz ne kadar? Loglar hangi yöntemlerle iletilecek? Ayrıştırma ve zenginleştirme işlemlerine ihtiyacımız var mı? Logları kaç gün saklayacağız? Hangi dönemlerdeki kayıtları ne sıklıkta sorgulayacağız? Kaynak sistemlerimiz ve Elasticsearch arasındaki bağlantı kesilirse ne kadar süre veri kaybetmeden çalışabilmeliyiz? Bu soruların cevapları, yalnızca Elasticsearch kapasitesini değil, Logstash kullanıp kullanmayacağımızı, Logstash üzerinde ne kadar işlemci ve bellek gerekeceğini, Persistent Queue (Kalıcı Kuyruk) için ne kadar disk ayıracağımızı, merkezi bir mesaj kuyruğuna ihtiyaç duyup duymadığımızı ve veri toplama katmanının nasıl yedekli çalışacağını da etkiliyor.
Üstelik merkezi log yönetimi söz konusu olduğunda başlangıç verisinin büyüklüğü, Elasticsearch üzerinde oluşacak gerçek disk tüketimiyle bire bir aynı değil. Çünkü Elasticsearch kayıtları yalnızca ham metin olarak saklamıyor. Veriyi arayabilmek ve analiz edebilmek için indeks yapıları oluşturuyor, çeşitli alanları farklı biçimlerde depoluyor ve uygun durumlarda sıkıştırıyor. Bu nedenle 100 GB ham log verisinin Elasticsearch üzerindeki karşılığı, veri yapısına, alan eşlemelerine ve kullanılan optimizasyonlara bağlı olarak 100 GB’den küçük ya da büyük olabilir. Bunun üzerine bir de veri dayanıklılığı için oluşturduğumuz kopyalar ekleniyor.
Burada küçük bir örnek üzerinden ilerlemek istiyorum. Bir kurumun günlük ortalama 100 GB log ürettiğini ve bu logları 30 gün saklamak istediğini düşünelim. Basitlik açısından, ham verinin Elasticsearch’te indekslendikten sonra da aynı büyüklükte yer kapladığını varsayalım. Bu durumda 30 günde 3 TB birincil indeks verisi oluşur.
Elasticsearch, bir indeksin verilerini shard adı verilen parçalara dağıtarak farklı veri düğümlerinde saklar. Her birincil shard için bir replica yani kopya oluşturduğumuzda, bu verinin başka bir düğümde ikinci bir kopyası da tutulur.
Böylece 3 TB birincil verimiz, bir replica ile yaklaşık 6 TB yerel shard depolama alanına ihtiyaç duyar.
Ancak hesabımız burada bitmez. Disklerin tamamen dolu çalışmasını istemeyiz. Yeni veriler için boş alan, shard taşıma işlemleri, segment birleştirme, arıza sonrası kurtarma ve gelecekteki büyüme için ilave kapasite gerekir.
Örneğimizde disklerin en fazla %75 dolulukta çalışmasını bir planlama hedefi olarak belirlersek, 6 TB veriyi barındırabilmek için yaklaşık 8 TB tahsis edilmiş disk kapasitesi ayırmamız gerekir. Dikkat edelim: Henüz kaç Elasticsearch node kullanacağımızı, bu node’ların işlemci ve bellek gereksinimlerini, disklerinin performansını, snapshot alanını veya yedek veri merkezi ihtiyacını hesaplamadık.
Dolayısıyla günlük 100 GB log saklanacak bir sistem için yalnızca “30 günlük 3 TB veri var, 3 TB disk yeterlidir” demek son derece yanıltıcı olabilir. Peki aynı kurumun günlük loglarının yalnızca son yedi gününü yoğun biçimde sorguladığını, kalan 23 güne ise çok daha seyrek eriştiğini düşünürsek? İşte Elasticsearch’ün Hot, Warm, Cold ve Frozen veri katmanları burada anlam kazanıyor.
Hot, yeni verilerin yazıldığı ve sık sorgulandığı katman. Bu nedenle yüksek disk performansı ve yeterli işlem gücü önemli. Warm, daha eski ve daha az sorgulanan kayıtların tutulabildiği katman. Cold, seyrek erişilen tarihsel veri için daha ekonomik bir yaklaşım sağlayabiliyor. Frozen ise çok nadiren erişilen büyük veri kümelerinin daha düşük yerel disk ihtiyacıyla aranabilmesine imkân tanıyor.
Buradaki önemli nokta şu: Bu katmanlar birer disk markası veya fiziksel disk türü değil, verinin erişim ve yaşam döngüsü gereksinimlerine göre tasarlanan Elasticsearch rolleridir. Örneğimizde yalnızca Hot ve Warm kullandığımızı düşünelim. Günlük 100 GB indekslenmiş veri ve bir replica varsayımıyla ilk yedi gün için yaklaşık 1,4 TB, sonraki 23 gün için ise 4,6 TB yerel shard kapasitesi gerekir. Toplam veri hacmimiz hâlâ yaklaşık 6 TB’dir; ancak artık bu verinin tamamını aynı performans sınıfındaki depolama üzerinde tutmamız gerekmeyebilir.
Bu ayrımın ekonomik değeri oldukça büyük.
Hot katmanında yüksek performanslı Solid-State Drive / NVMe kullanırken, Warm katmanında ölçülmüş performans ihtiyacını karşılayan daha ekonomik bir depolama altyapısı seçebiliriz. Elbette yedi gün Hot, 23 gün Warm kullanmak bütün kurumlar için geçerli bir kural değil. Belki müşterinin bütün loglarına 30 gün boyunca hızlı erişmesi gerekiyor. Belki de yalnızca son 48 saatteki logları yoğun biçimde sorguluyor. Veri katmanlarını belirleyen şey yalnızca saklama süresi değil, veriye erişim biçimi ve performans beklentisidir.
Daha uzun saklama sürelerinde ise Searchable Snapshot teknolojisi dikkat çekici bir seçenek hâline geliyor.
Normal snapshot, Elasticsearch verilerinin ayrı bir repository üzerinde saklanan kurtarılabilir yedeğidir. Searchable Snapshot ise bu snapshot üzerindeki verinin yeniden klasik bir indeks olarak tamamen geri yüklenmesine gerek kalmadan aranabilmesini sağlar.
Cold katmanında kullanılan Fully Mounted yaklaşımında, indeksin shard verileri yerel diskte tutulur. Snapshot repository ise bu verinin dayanıklı kaynağı olur. Böylece bazı senaryolarda yerel replica ihtiyacını kaldırarak disk kullanımını yaklaşık yarıya indirebiliriz.
Frozen katmanında kullanılan Partially Mounted yaklaşımında ise verinin tamamının yerel diskte bulunması gerekmez. Verinin kalıcı kopyası snapshot repository üzerinde tutulurken, sorguların ihtiyaç duyduğu dosya parçaları yerel önbelleğe alınır. Bu, çok büyük tarihsel veri kümelerinin daha düşük yerel disk kapasitesiyle aranabilmesi açısından son derece değerli.
Ancak burada başka bir maliyet kalemi ortaya çıkar: Snapshot repository’nin kapasitesi, dayanıklılığı, erişim performansı ve ağ bağlantısı. Üstelik searchable snapshot’ların tutulduğu repository artık yalnızca geleneksel bir yedekleme alanı değildir; tarihsel verilerin erişilebilirliğinde aktif rol oynayan kritik bir altyapı bileşenidir. Düzenli backup politikalarıyla searchable snapshot yaşam döngüsünün bu nedenle birlikte, ancak birbirinden farklı amaçlarla tasarlanması gerekir.
Tüm bunların yanında Elastic’in LogsDB, gelişmiş sıkıştırma, Synthetic _source ve zaman serisi verileri için Downsampling gibi optimizasyonları da storage hesabımızı etkileyebilir. Bu özelliklerin sağlayacağı tasarruf ise kullanılan sürüme, veri yapısına, lisans kapsamına ve gerçek iş yüküne bağlıdır. Bir başka ifadeyle, storage kapasitesini hesaplarken yalnızca veri miktarını değil, verinin nasıl indekslendiğini, nasıl çoğaltıldığını, nasıl sıkıştırıldığını ve ne şekilde saklandığını da bilmeliyiz.
Şimdi ikinci bir senaryoyu düşünelim. Bu kez amacımız merkezi log toplamak değil, yeni geliştirilen uygulama servislerinin performansını izlemek olsun. Application Performance Monitoring (APM — Uygulama Performansı İzleme) kapsamında artık günlük log hacmi tek başına yeterli bir girdi değildir. Kaç servis izlenecek? Dakikada kaç işlem gerçekleşiyor? Bir işlem sırasında ortalama kaç operasyon ölçülüyor? Bu işlemlerin ne kadarlık bölümü ayrıntılı trace olarak saklanacak? Performans metrikleri ve trace kayıtları ne kadar süre tutulacak? Örneğin dakikada 1.000 işlem gerçekleştiren bir uygulamada her işlem ortalama 10 span üretiyorsa, bütün işlemler ayrıntılı biçimde izlendiğinde dakikada yaklaşık 10.000 span oluşabilir. Span, bir işlemin belirli operasyonunu ve süresini temsil eder. Trace ise bu operasyonların uçtan uca ilişkilendirilmiş bütünüdür. Bu kez storage hesabımızı yalnızca log boyutu değil, işlem hacmi, span sayısı, işlem bağlamı, örnekleme politikası ve saklama süresi belirliyor. Sampling yani örnekleme yaklaşımıyla bütün trace’leri ayrıntılı saklamak yerine belirli bir bölümünü koruyabiliriz. Ancak örnekleme oranını rastgele seçmek doğru değil. Kritik işlemler, hata analizi, gecikme araştırmaları ve denetim gereksinimleri birlikte değerlendirilmeli. Ayrıca modern OpenTelemetry tabanlı mimarilerde uygulama SDK’ları, Collector bileşenleri ve merkezi telemetry gateway’leri de kapasite planlamasına dâhil olur. Böylece aynı Elasticsearch altyapısı üzerinde log, metric ve trace verilerini birlikte tutmak mümkün olsa da bu kullanımın işlemci, bellek, disk, veri işleme ve sorgu maliyetlerinin ayrı ayrı değerlendirilmesi gerekir.
Buradan mimari tasarımın belki de en kritik aşamasına geliyoruz. Elasticsearch cluster’ımız kaç node’dan oluşmalı? Bu node’ların hangileri cluster yönetiminden, hangileri veri saklama ve sorgulama işlemlerinden sorumlu olmalı? Gerekirse Elasticsearch’ün kendi ingest işlemlerini ayrı node’larda mı çalıştırmalıyız? Logstash gibi bağımsız veri işleme bileşenlerini nerede ve hangi kapasitede konumlandırmalıyız? Master-eligible node’larımızın cluster yönetim yüküyle data node’larımızın indeksleme ve sorgulama yükünü birbirinden ayırmalı mıyız? Her node’a kaç sanal işlemci, ne kadar bellek, ne kadar JVM heap ve ne büyüklükte disk ayırmalıyız? JVM, Java Virtual Machine (Java Sanal Makinesi) anlamına geliyor. Bu noktada yalnızca toplam RAM miktarı değil, Elasticsearch’ün bellek kullanım davranışı, işletim sistemi önbelleği, shard sayısı, sorgu yoğunluğu ve disk performansı da önem kazanıyor.
Benzer bir değerlendirmeyi Logstash için de yapmalıyız. Kaç pipeline çalışacak? Ayrıştırma kuralları ne kadar karmaşık? Hangi veri hızını karşılayacak? Elasticsearch erişilemez olduğunda kaç saatlik veriyi diskte tamponlayacak? Tek bir Logstash sunucusu yeterli mi, yoksa birden fazla instance ile yük dağılımı ve süreklilik mi sağlamalıyız? Kibana’yı, Fleet Server’ı, gateway bileşenlerini ve gerektiğinde diğer veri toplama servislerini de bu bütünün dışında düşünemeyiz. Dahası, High Availability (HA — Yüksek Erişilebilirlik) yalnızca Elasticsearch üzerinde replica shard bulundurmak anlamına gelmiyor. Veri toplama katmanı, sorgu erişimi, yönetim bileşenleri, snapshot altyapısı ve gerekli ağ servisleri de uygun biçimde yedeklenmeli. Üç Elasticsearch master-eligible node’unun bulunması, bu node’ların aynı fiziksel sunucuda veya aynı hata alanında bulunmasını doğru bir tasarım hâline getirmez. Aynı şekilde bütün data node’larını tek bir storage sistemine bağımlı kılarsak, sunucu seviyesindeki yedeklilik bizi ortak storage arızasından koruyamayabilir. Bu nedenle mimarimizi çizerken fiziksel sunucuların, sanallaştırma altyapısının, disk sistemlerinin, ağ bileşenlerinin ve bağımsız hata alanlarının birbirleriyle ilişkisini de göstermeliyiz.
Coğrafi yedeklilik gereksinimi varsa konu daha da genişliyor. Bir veri merkezinin tamamen devre dışı kalması durumunda sistemin ne kadar sürede ayağa kalkması bekleniyor? Kabul edilebilir veri kaybı nedir? İkinci bir Elasticsearch cluster’ına ihtiyaç var mı? Cross-Cluster Replication (CCR — Cluster’lar Arası Replikasyon), ayrı snapshot repository’leri veya farklı bir felaket kurtarma yaklaşımı mı kullanılmalı? Üstelik birincil veri merkezinin devre dışı kalması hâlinde ikinci lokasyonun yalnızca veriyi saklaması değil, gerekli sorgulama ve veri toplama yükünü de karşılayabilmesi gerekiyor.
Bütün bu soruların cevapları bizi tekrar toplam sahip olma maliyetine getiriyor. Çünkü artık yalnızca abonelik bedelini değil; fiziksel sunucuları, sanal işlemci ve bellek kaynaklarını, yüksek performanslı ve kapasite odaklı storage katmanlarını, Object Storage ihtiyacını, veri merkezi yedekliliğini, ağ bant genişliğini, yedekleme operasyonlarını, enerji tüketimini ve sistemin yönetim maliyetlerini de konuşuyoruz. Ve bu maliyetler üzerinde en büyük etkiye sahip kararlardan bazıları, yazılımın kurulmasından önce veriliyor.
Elasticsearch için tek bir doğru node sayısı, tek bir doğru disk tipi veya her kuruma uygulanabilecek sabit bir Hot/Warm/Cold politikası yok. Doğru mimari; kullanım senaryosuna, veri hacmine, indeksleme ve sorgu davranışına, saklama politikasına, performans beklentisine ve hizmet sürekliliği gereksinimlerine göre şekilleniyor.
Bu yüzden benim için kapasite planlamasının en önemli çıktısı yalnızca bir lisans veya donanım tablosu değil.
Öncelikle kâğıt üzerinde oluşturulmuş, her bileşenin görevinin, kaynağının, veri akışının ve arıza durumundaki davranışının anlaşılabildiği bir mimari topoloji. Bu topolojiyi oluşturduktan sonra, gerçek verilerle yapılacak pilot çalışmalar, indeksleme ve sorgu testleri, kapasite ölçümleri ve olası arıza senaryolarıyla varsayımlarımızı doğrulayabiliriz. Ancak o zaman ne kadar kaynağa ihtiyacımız olduğunu, hangi kaynakların kritik olduğunu ve hangi yatırımların gerçekten gerekli olduğunu daha güvenilir biçimde belirleyebiliriz.
Ben teknolojik yatırımlarda en değerli tasarrufun, her zaman en ucuz ürünü seçmekten değil, doğru mimariyi tasarlayarak gereksiz kaynak tüketimini ve ileride ortaya çıkabilecek pahalı hataları önlemekten geçtiğine inanıyorum. Çünkü iyi bir mimari yalnızca bugün çalışacak bir sistem kurmak değildir. Gelecekte büyüyebilen, gerektiğinde kurtarılabilen, performansı öngörülebilen ve maliyeti yönetilebilen bir sistem tasarlamaktır.
Sarav Asiye Yiğit * 13 Kasım 2026
Kaynaklar
[1] Elastic Size Your Elasticsearch Shards
[2] Elastic Tune for Disk Usage
[3] Elastic Elasticsearch Data Tiers
[4] Elastic Searchable Snapshots
[5] Elastic Logstash Persistent Queues
[6] Elastic APM Storage and Sizing Guide
[7] Elastic Design for Resilience
[8] Elastic Cross-Cluster Replication
[9] Elastic OpenTelemetry Reference Architecture
[10] Elastic Self-Managed Subscription Contracting Overview